
Insights · FachartikelKI-gestützte Ursachenanalyse in der Produktion: Vom bloßen Verdacht zur echten Ursache
Alarm in Sekunden, Ursachensuche in Wochen: Warum die klassische Root Cause Analyse zu langsam ist
In einer vernetzten Fertigung funktioniert die Statistische Prozesslenkung (SPC) wie ein hochempfindlicher Rauchmelder: Er schlägt sofort an, sobald ein Wert aus dem Ruder läuft. Die digitalen Regelkarten zeigen verlässlich, dass es brennt – wo genau der Brandherd liegt und warum er ausgebrochen ist, bleibt jedoch unklar.
Die eigentliche Arbeit beginnt erst danach: die Root Cause Analyse. In der Praxis kostet diese oft Tage oder gar Wochen. Interdisziplinäre Teams tragen mühsam Daten aus MES, Historian, LIMS, ERP und der Instandhaltung zusammen, stellen Hypothesen auf und arbeiten diese nacheinander ab. Das Problem: Meistens untersucht man dabei nur das, was man ohnehin schon vermutet.
Werkzeuge zur automatisierten Ursachenanalyse versprechen diesen langwierigen Schritt drastisch zu verkürzen. Dieser Beitrag beleuchtet, wie solche Verfahren typischerweise arbeiten, wo sie methodisch an ihre Grenzen stoßen und welchen entscheidenden Unterschied eine objektzentrierte Datenmodellierung in Kombination mit kausalen Methoden machen kann.
Der klassische Fünf-Schritt-Prozess und seine blinden Flecken
Die meisten modernen Analyseansätze folgen einem standardisierten Ablauf:
Signal erkennen: Ein SPC-Alarm, Ausreißer in der optischen Prüfung oder eine sinkende Prozessfähigkeit (sinkender Cpk Wert - Process Capability Index) lösen die Analyse aus.
Zeitfenster definieren: Das relevante Betrachtungsfenster vor dem Signal wird festgelegt – abgestimmt auf die jeweiligen Taktzeiten und Bearbeitungsschritte der Linie.
Variablen sammeln: Alle verfügbaren Prozessgrößen werden zusammengetragen (z. B. Temperaturen, Drücke, Drehmomente, Werkzeug-IDs, Materialkomponenten, Schichten).
Zusammenhänge bewerten: Jede Variable wird mathematisch gegen das Qualitätsmerkmal getestet – beispielsweise über Korrelationskoeffizienten (stetig), Chi-Quadrat-Tests (kategorial) oder SHAP-Werte.
Ranking ausgeben: Das System liefert eine nach Stärke sortierte Liste auffälliger Variablen für das Qualitätsteam.
Obwohl dieser simultane Blick auf alle Variablen einen echten Fortschritt gegenüber der manuellen Suche darstellt, leidet die klassische Methode unter drei zentralen Schwächen:
Scheinkorrelationen: Eine hoch gerankte Variable ist oft nur eine Begleiterscheinung oder Folge, nicht aber die eigentliche Ursache des Fehlers.
Verborgene Confounder (Störvariablen): Fallen eine neue Materiallieferung und eine bestimmte Schicht zeitlich zusammen, korrelieren beide mit dem Fehler. Ein einfaches Ranking kann diese Effekte nicht trennen.
Blinde Flecken bei Kombinationen: Reine Paartests übersehen Fehler, die erst durch das komplexe Zusammenspiel mehrerer, isoliert unauffälliger Bedingungen entstehen.
Automatisierte Werkzeuge liefern daher per se keine Beweise, sondern statistisch begründete Hypothesen. Wie präzise diese sind, entscheidet sich bereits weit vor dem Algorithmus: bei der Datenaufbereitung.
Das Nadelöhr: Die flache Tabellenstruktur als Sackgasse
Produktionsdaten liegen naturgemäß tief fragmentiert vor: Prozesswerte im Sekundentakt (Historian), Auftragsdaten (MES), Materialstammdaten (ERP), Wartungsereignisse (Instandhaltung) und Prüfergebnisse (LIMS).
Klassische Analyseverfahren benötigen jedoch zwingend eine flache Datentabelle mit exakt einer Zeile pro Fall. Das zwingt Unternehmen dazu, Daten vorab zu verknüpfen und massiv zu verdichten (z. B. zu Mittelwerten pro Bauteil oder zum letzten Wert vor dem Ereignis).
Jede dieser Verdichtungen ist eine irreversible Vorentscheidung. Wer Werkzeugtemperaturen zum Mittelwert eindampft, übersieht kurze, kritische Kraft- oder Hitzespitzen beim Fügeprozess. Die Auswahl der Merkmale bestimmt also im Vorfeld, welche Ursachen das System überhaupt finden kann. Damit kehrt genau die Hypothesenabhängigkeit durch die Hintertür zurück, die man durch die Automatisierung eigentlich eliminieren wollte.
Die objektorientierte Datensicht: Das Werkstück im Fokus
Ein moderner Gegenentwurf verzichtet auf die starre Vorab-Verdichtung. Stattdessen werden alle Daten flexibel um das reale Analyseobjekt der diskreten Fertigung herum organisiert – dem gefertigten Teil.
Xplain Data realisiert diesen Ansatz mit der patentierten ObjectAnalytics™-Technologie. Jedes physische Bauteil wird als digitales Objekt modelliert, das seine ursprüngliche Datenstruktur vollständig beibehält:
Durchlaufene Arbeitsgänge inklusive präziser Zeitstempel, Maschine und Nest- oder Werkzeug-ID
Die hochaufgelösten Original-Prozessverläufe (z. B. Drehmomentkurven) während der Bearbeitung
Zugeordnete Komponenten samt Qualitätswerten der Wareneingangsprüfung
Exakte Wartungs- und Kalibrierhistorien der beteiligten Anlagen
Der entscheidende Vorteil: Komplexe Merkmale (wie „Werkzeug war beim zweiten Arbeitsgang bereits über der kritischen Zyklenzahl“ oder „Letzte Kalibrierung lag über zehn Tage zurück“) müssen nicht vorab definiert werden. Sie werden während der Analyse dynamisch aus dem Objekt abgeleitet. Die Suche startet ohne vorgefertigte Annahmen: Das System durchleuchtet das gesamte Objekt flexibel auf relevante Faktoren und Zeitbezüge.
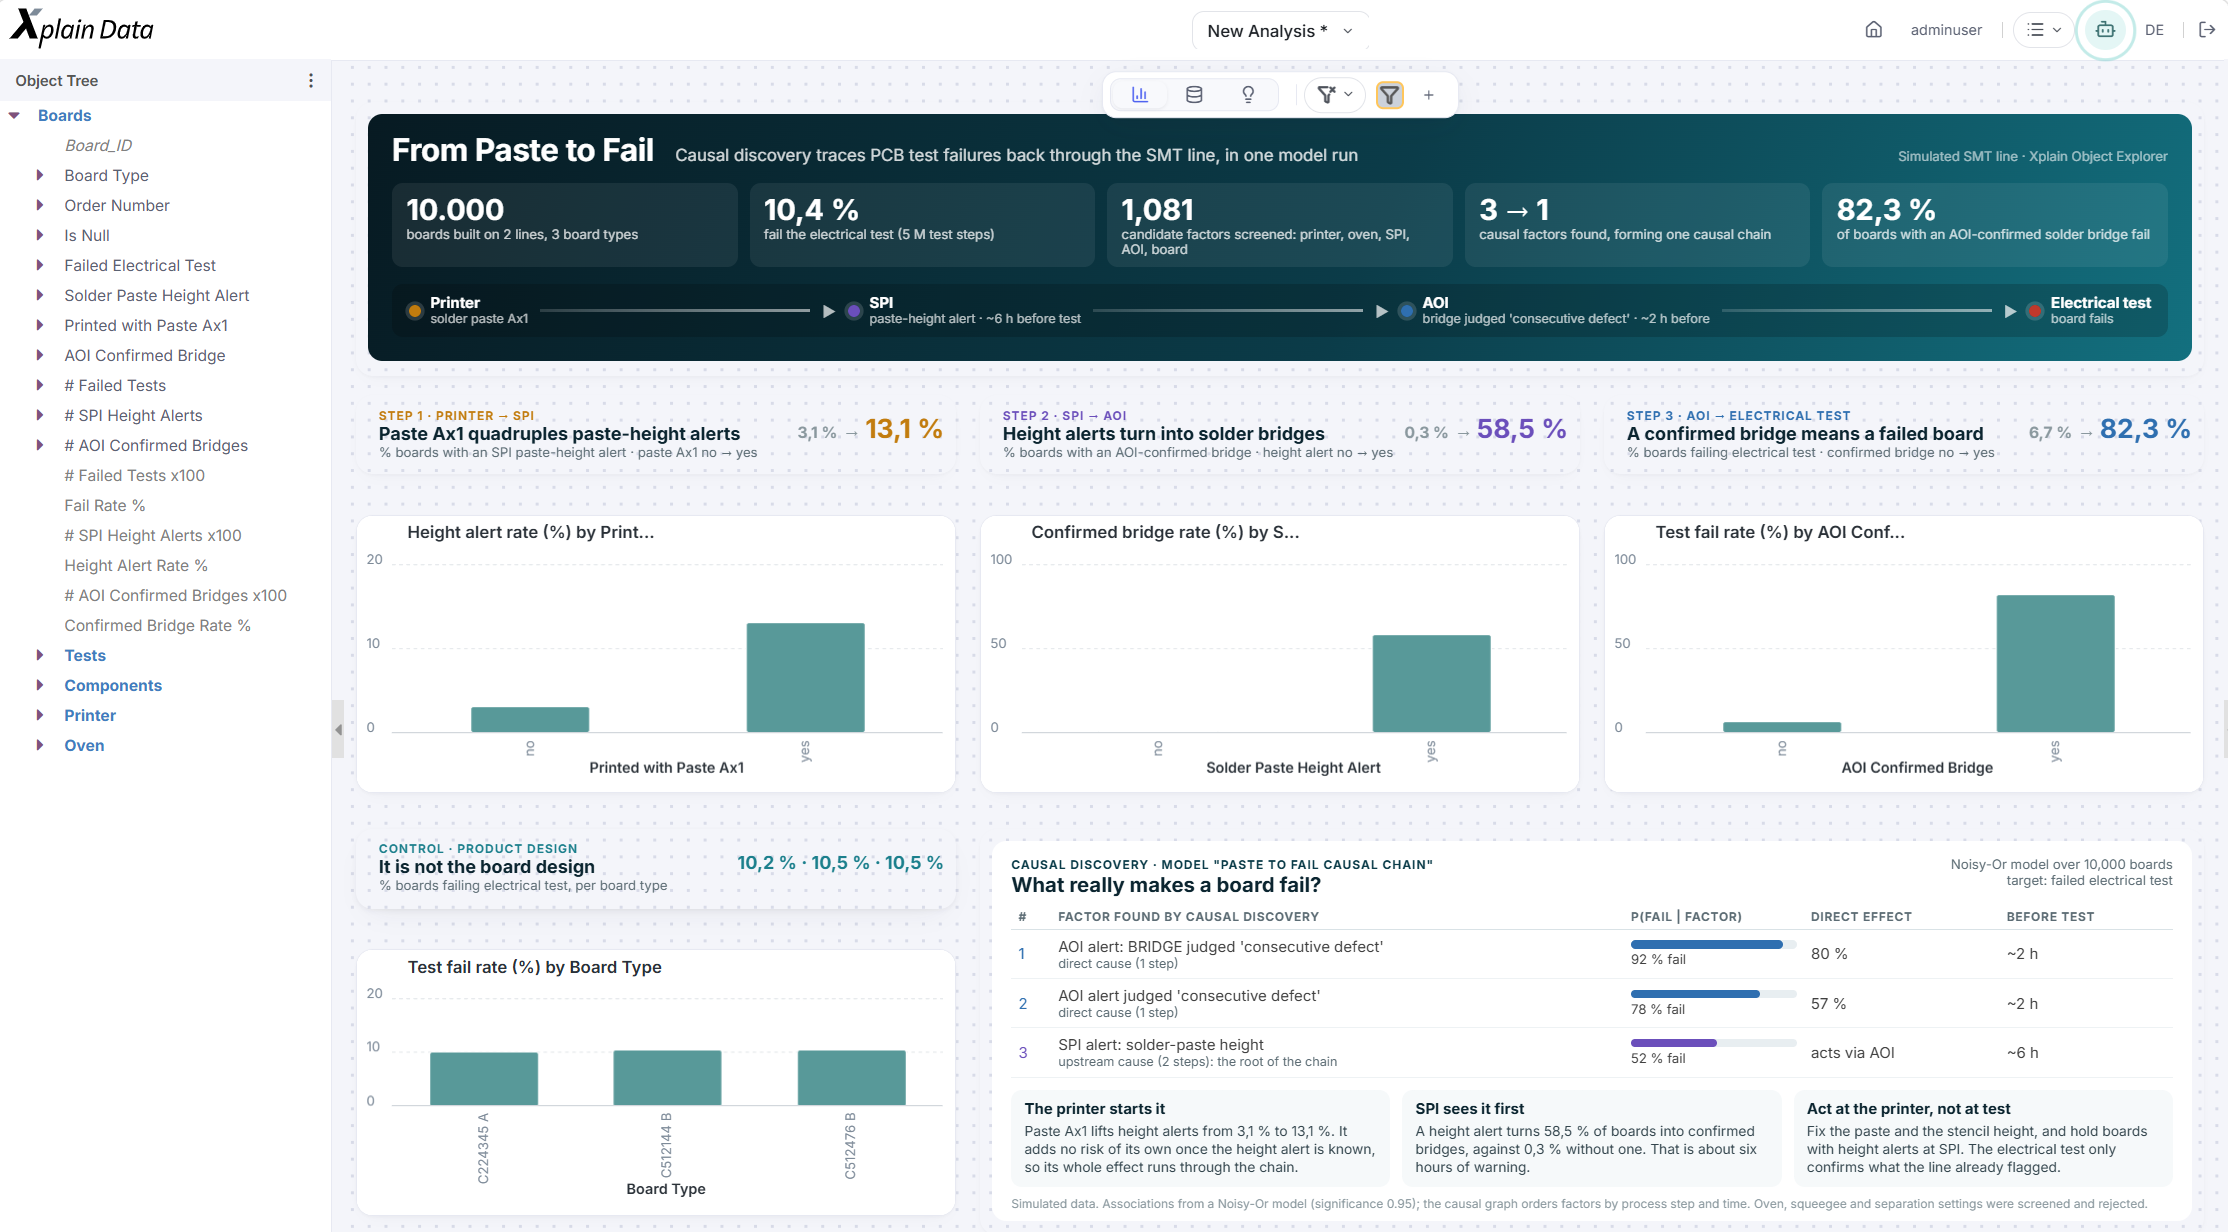
Vom bloßen Verdacht zur Kausalität: Störfaktoren clever isolieren
Um Scheinzusammenhänge von echten Ursachen zu trennen, prüfen kausale Verfahren, ob ein statistischer Zusammenhang auch dann stabil bleibt, wenn man andere Einflussfaktoren kontrolliert.
Ein klassisches Praxisbeispiel veranschaulicht das Confounder-Problem:
Ausschuss tritt vermehrt in der Nachtschicht auf.
In der Nachtschicht wird primär Material von Lieferant B verarbeitet, da dessen Lieferungen abends eintreffen.
Ein paarweiser Standardtest markiert prompt beide Faktoren als hochgradig verdächtig.
Werden Schicht und Materialkomponente jedoch mathematisch kombiniert betrachtet, löst sich der Schichteffekt statistisch auf. Das Material ist die wahre Ursache. Die Schicht hängt nur deshalb mit dem Fehler zusammen, weil dort vor allem dieses Material verarbeitet wird. Für die Praxis ist diese Erkenntnis geschäftskritisch: Eine teure Schulung der Nachtschicht wäre völlig wirkungslos geblieben.
Der CausalDiscoverer von Xplain Data setzt direkt auf der objektzentrierten Datenbasis (ObjectAnalytics) an. Er isoliert echte Treiber von reinen Scheinkorrelationen und liefert statt einer eindimensionalen Variablenliste ein transparentes, kausales Abhängigkeitsnetzwerk.
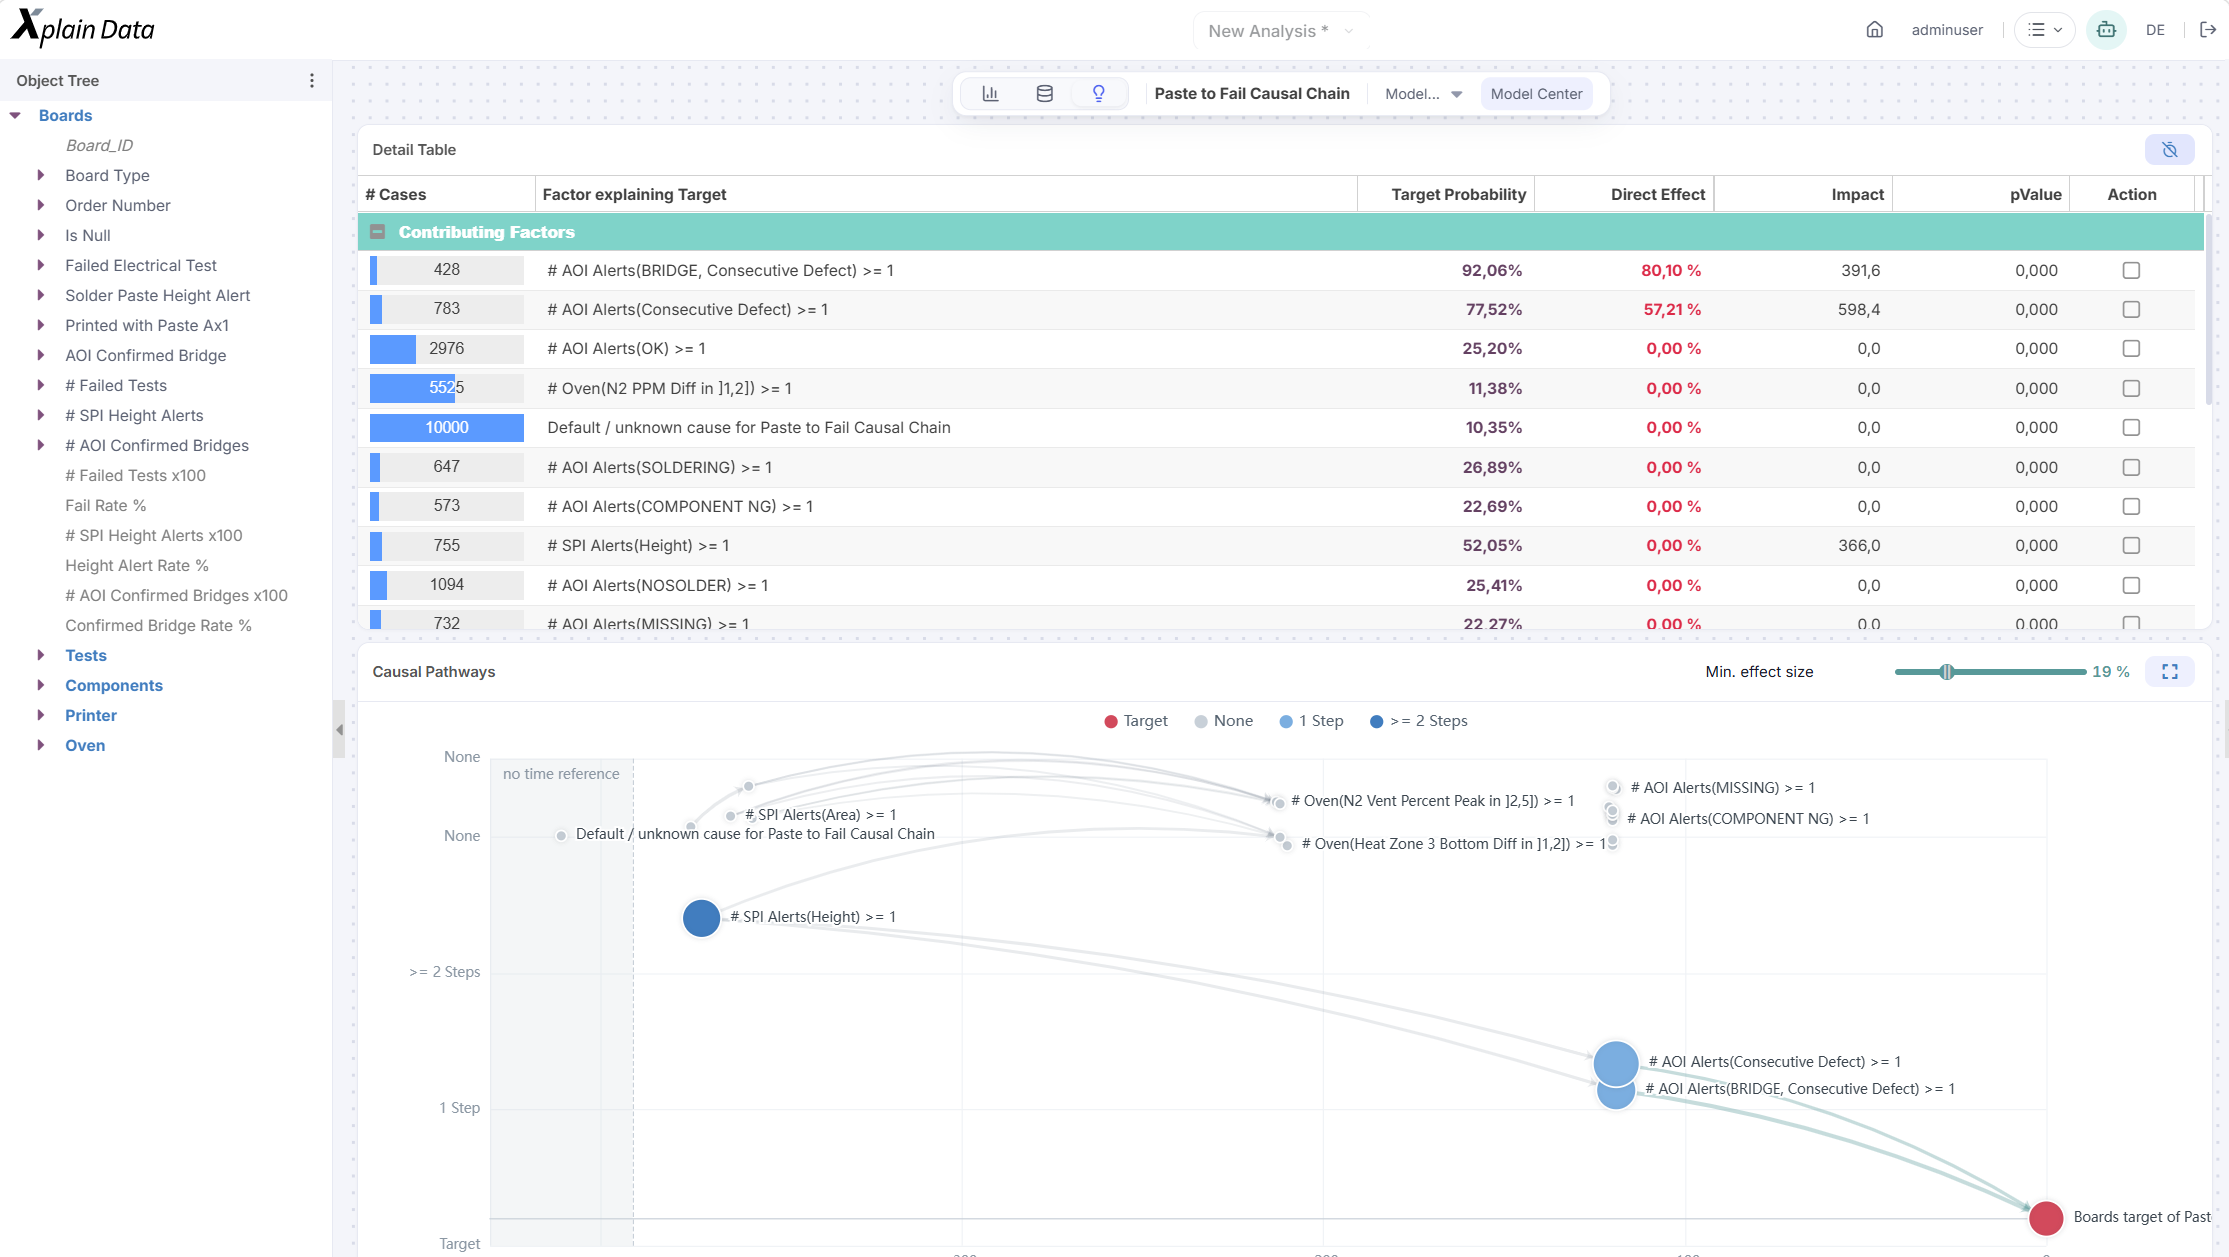
In der Praxis: Ausschussanalyse an einer Bearbeitungslinie
An einer Präzisionslinie steigt die Ausschussquote im Endtest über Wochen hinweg schleichend an. Die klassischen SPC-Karten schlagen nicht an, da alle Einzelparameter innerhalb der Toleranzgrenzen liegen. Eine einfache Korrelationsanalyse zeigt nur diffuse, schwache Signale bei Schicht, Maschine 3 und Lieferant B.
Durch die objektzentrierte Modellierung jedes Bauteils fördert die automatisierte kausale Suche folgendes Bild zutage:
| Faktor | Paarweise Betrachtung (Klassisch) | Kausale Betrachtung (Unter Berücksichtigung aller Faktoren) |
|---|---|---|
| Nachtschicht | Auffällig | Kein eigenständiger Effekt (Scheinkorrelation) |
| Lieferant B | Auffällig | Kein eigenständiger Effekt (Scheinkorrelation) |
| Maschine 3 | Schwach auffällig | Nur in einer bestimmten Kombination relevant |
| Werkzeug über Standzeitgrenze UND Komponente mit erhöhter Härte | Nicht geprüft (in flacher Tabelle blind) | Deutlicher, kausaler Effekt |
Das kritische Kombinationsmerkmal in der letzten Zeile existierte in keiner Ursprungstabelle. Es entstand erst durch die dynamische Verknüpfung des exakten Werkzeugzustands mit den Härtewerten der Materialkomponente zum exakten Bearbeitungszeitpunkt.
Lieferant B und die Nachtschicht erschienen in der Standardanalyse nur deshalb fehlerhaft, weil das härtere Vormaterial zufällig dort verbaut wurde. Die abgeleitete Maßnahme ist nun eindeutig: Die Standzeitgrenzen des Werkzeugs müssen dynamisch verkürzt werden, sobald härteres Material eingepflegt wird.
Wo die Automatisierung an ihre Grenzen stößt
Kein Algorithmus der Welt kann Ursachen finden, die nicht digital erfasst sind. Eine verlässliche automatisierte Analyse steht und fällt mit fünf Säulen:
Lückenlose Rückverfolgbarkeit (Traceability): Jedes Bauteil muss eindeutig mit seinen Arbeitsgängen, Maschinen und verbauten Komponenten verknüpft sein.
Konsistente Zeitstempel: Uhren von Prozess-, Wartungs- und Prüfsystemen müssen synchron laufen, um zeitliche Bezüge exakt zu rekonstruieren.
Ausreichende Datenbasis: Um seltene Fehlerkombinationen statistisch sauber vom Zufall zu trennen, wird eine valide Anzahl an Fallbeispielen benötigt.
Domänenwissen: Die Ergebnisse KI-gestützter Systeme dürfen niemals ungeprüft übernommen werden. Prozessexperten müssen die statistischen Hypothesen stets auf technische Plausibilität prüfen.
Verborgene Variablen: Nicht gemessene Umgebungseinflüsse (wie Hallentemperatur oder Luftfeuchtigkeit) können weiterhin als unsichtbare Störfaktoren wirken.
Automatisierte Systeme ersetzen daher weder bewährte SPC-Karten noch strukturierte Problemlösungsmethoden wie Ishikawa, 5-Why oder 8D-Reports. Sie schließen vielmehr die kritische Lücke dazwischen: Sie verkürzen den Weg vom ersten Werkstück-Alarm bis zur fundierten, prüfbaren Hypothese radikal.
Der große Vorteil eines Systems, welches die Produktion automatisch und kontinuierlich überwacht (durch den Causal DiscoveryBot, ein Add-on zum CausalDiscoverer), liegt dabei darin, dass Probleme nicht zuerst so gehäuft oder so gravierend auftreten müssen, dass sie den ganzen Produktionsprozess aufhalten, um dann unter großem Aufwand und Zeitdruck die tatsächliche Ursache finden zu müssen. Typischerweise werden erst dann die relevanten Daten, Ereignisse und Experten zusammengeführt, um gezielte Analysen durchzuführen. Dies ist nicht nur ineffizient, sondern kann auch zur Verschlechterung der Liefertreue führen.
In einem automatisierten Daten-Modell hingegen, wo neue Daten regelmäßig (wöchentlich, täglich, stündlich, …) eingespielt werden, können diese ebenso regelmäßig und unmittelbar auf Veränderungen untersucht werden. So können bereits bei einem kleinen Verdacht Alarme geworfen werden, um diesen so schnell wie möglich zu überprüfen und um die oben genannten Szenarien zu vermeiden.
Fazit: Objektive Hypothesen statt menschlicher Vorannahmen
Die automatisierte Ursachenanalyse minimiert die Reaktionszeit zwischen der Fehlererkennung und der finalen Abhilfemaßnahme in der diskreten Fertigung entscheidend. Die Qualität der Ergebnisse wird dabei weniger vom gewählten Algorithmus bestimmt als von der zugrundeliegenden Datenstruktur und dem mathematischen Umgang mit Confoundern.
Klassische Werkzeuge, die auf vorab verdichteten, flachen Tabellen aufsetzen, replizieren lediglich die menschlichen Hypothesen der Merkmalsauswahl. Eine objektzentrierte Datenhaltung (durch ObjectAnalytics) hält hingegen die volle Detailtiefe der diskreten Fertigungsschritte flexibel abrufbereit. Darauf aufbauend trennen kausale Verfahren (CausalDiscoverer) echte Prozesstreiber von bloßem statistischem Rauschen. Das Ergebnis ist eine datengestützte, objektive Hypothese – frei von menschlichen Vorannahmen.
Häufige Fragen zur KI-gestützten Ursachenanalyse
Was ist eine Root Cause Analyse in der Produktion?
Eine Root Cause Analyse (Ursachenanalyse) sucht die eigentliche Ursache eines Qualitätsproblems, etwa steigenden Ausschuss oder Maßabweichungen. Sie beginnt meist dann, wenn die Statistische Prozesslenkung (SPC) eine Abweichung meldet. Ziel ist eine Maßnahme, die das Problem dauerhaft behebt und nicht nur das Symptom.
Warum reicht SPC allein nicht aus?
SPC zeigt zuverlässig, dass sich ein Prozess verändert hat. Warum er sich verändert hat, zeigt sie nicht. Außerdem überwachen Regelkarten meist einzelne Parameter. Probleme, die erst durch das Zusammenspiel mehrerer unauffälliger Größen entstehen, bleiben deshalb oft unentdeckt.
Was ist der Unterschied zwischen Korrelation und Kausalität?
Eine Korrelation bedeutet nur, dass zwei Größen gemeinsam auftreten. Kausalität bedeutet, dass die eine Größe die andere tatsächlich beeinflusst. In der Fertigung ist der Unterschied entscheidend: Eine Maßnahme an einem nur korrelierenden Faktor bleibt wirkungslos.
Was ist ein Confounder?
Ein Confounder (Störvariable) ist ein Faktor, der zwei andere Größen gleichzeitig beeinflusst und so einen Scheinzusammenhang zwischen ihnen erzeugt. Ein Beispiel: Wird ein bestimmtes Material vor allem in der Nachtschicht verarbeitet, kann die Nachtschicht fehleranfällig wirken, obwohl das Material die Ursache ist. Kausale Verfahren berücksichtigen solche Faktoren, einfache Korrelationsrankings tun das nicht.
Welche Daten braucht eine automatisierte Ursachenanalyse?
Entscheidend ist die Rückverfolgbarkeit: Jedes Bauteil muss seinen Arbeitsgängen, Maschinen, Werkzeugen und Materialien zugeordnet werden können. Dazu kommen konsistente Zeitstempel aus Systemen wie MES, Historian, ERP, Instandhaltung und Prüfung. Außerdem braucht es genügend Fälle, um echte Muster vom Zufall zu unterscheiden.
Ersetzt eine KI-gestützte Ursachenanalyse Methoden wie Ishikawa, 5-Why oder 8D?
Nein. Sie ergänzt diese Methoden, indem sie den Weg von der erkannten Abweichung zu einer gut begründeten Hypothese verkürzt. Prozessexperten bewerten das Ergebnis weiterhin auf technische Plausibilität, und eine Maßnahme wird im Prozess bestätigt.
Wie arbeiten ObjectAnalytics und der CausalDiscoverer zusammen?
ObjectAnalytics führt alle Daten über alle Produktionsprozess-Schritte zu einem Bauteil in einem Objekt zusammen und erhält dabei ihre ursprüngliche Struktur. So entsteht eine vollständige Sicht auf das gefertigte Teil. Der CausalDiscoverer setzt darauf auf: Er durchsucht das Objekt ohne vorherige Annahmen (kein Feature Engineering nötig) nach Einflussfaktoren und trennt echte Ursachen von Scheinzusammenhängen.